国产异音异响检测系统工具:融合LSTM与自编码机器学习的异音检测
工业压缩机异音难以依靠人工识别?本文解析LSTM自编码器异音检测方法,融合谱质心与梅尔频谱特征,针对时序数据不平衡实现高精度异常检测,为工业设备预测性维护提供新的技术方案。>>江苏实时异音异响检测系统供应商-可定制化服务
一、 引言与研究背景
在现代石油与天然气工业中,中游(Midstream)天然气压缩机系统是维持整个生产线平稳运行的核心枢纽。压缩机通过为管道中的天然气提供压力,将上游的开采生产与下游的用户消耗紧密连接在一起。一个典型的压缩机系统结构极其复杂,通常包含发动机、曲轴箱、阀体、压缩气缸、冷却系统以及涡轮(Turbo)单元等多个子系统。由于压缩机的初始安装与资本投入极其高昂,任何关键组件的意外停机或突发故障不仅会产生巨额的维修费用,更会造成不可估量的停产经济损失。
为了提高系统的安全性与可靠性,工业界长期依赖定期巡检等传统的预防性维护策略。然而,传统巡检主要依靠经验丰富的技术人员在现场通过人耳“听诊”来排查异常声音。这种方法存在三个致命缺陷:首先,极度耗时且高度主观;其次,压缩机运行时的噪音分贝极高(甚至超过喷气式发动机),严重掩盖了早期的微弱故障异音;最后,压缩机泵站往往地处偏远,人工巡检的难度和危险系数极高。
为了突破这一瓶颈,由Pooyan Mobtahej 等人发表于《Computational and Mathematical Methods》的最新研究,提出了一种基于物联网(IoT)声学传感器与深度学习相结合的自动化预测性维护(Predictive Maintenance, PdM)框架。本文是该团队在声学异常检测领域的递进式研究,创新性地提出了一种长短期记忆网络与自编码器融合的混合架构(LSTM-Autoencoder, LSTM-AE),通过对采集的一维时间序列原始音频进行深度特征学习,实现了对压缩机涡轮组件异常声音的高效、精准拦截。
二、 核心科学挑战与研究动机
在针对工业音频的异常检测任务中,算法的选择直接决定了系统的落地价值。传统的时间序列分析与机器学习算法(如 K-means 聚类、随机森林 RF、支持向量机 SVM、孤立森林等)虽然在小规模数据集上表现尚可,但在处理高维、海量且包含极高工业环境噪声的声学数据时,往往面临特征提取能力不足和泛化性能差的困境。
在作者团队此前的先导性研究中,曾尝试将一维音频转化为二维梅尔频率倒谱系数(MFCC)图像,并借助预训练的图像识别网络(ResNet50)提取深度特征,随后结合主成分分析(PCA)与 SVM 进行分类。尽管该方法取得了优异的成绩,但它本质上是将音频当作静态“图片”来处理,忽略了音频信号作为时间序列(Time Series)所蕴含的强大前后文动态时序依赖关系。
基于上述深刻洞察,本研究的动机在于:寻找一种能够天然契合音频时间序列属性,且具备强大无监督/半监督特征压缩能力的深度神经网络。因此,循环神经网络(RNN)的高级变体——长短期记忆网络(LSTM),以及擅长在潜空间(Latent space)中剥离噪声的自编码器(Autoencoder),成为了构建全新机器听觉框架的完美拼图。
三、 核心方法与系统架构剖析
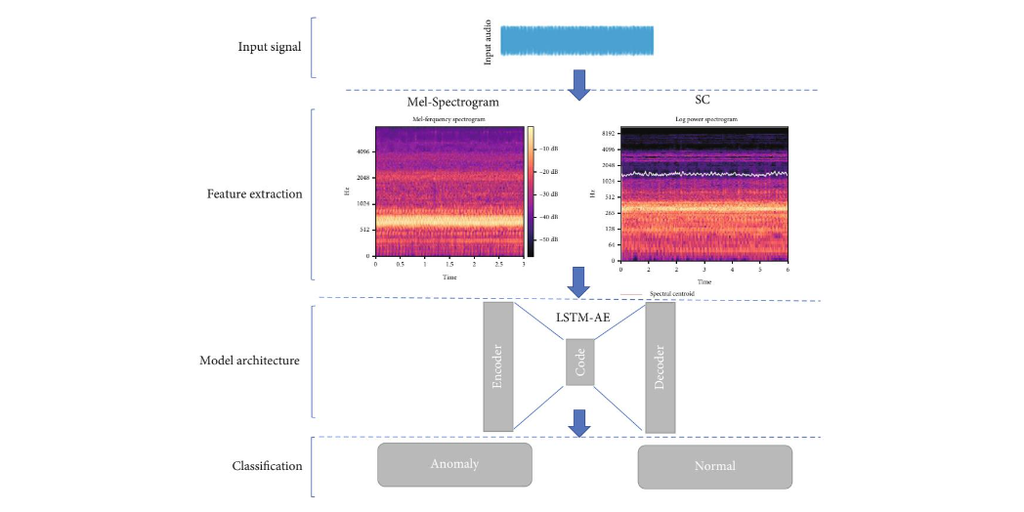
本研究提出了一条极其严密的端到端异常检测流水线,涵盖了从多源特征工程到深度序列建模的全过程。
1. 融合时频特征的声学特征工程 (Feature Extraction)
为了全面捕捉压缩机的声学指纹,系统不再依赖单一特征,而是从原始的一维音频波形中提取了两种极具互补性的声学特征:
- 谱质心 (Spectral Centroid, SC): 谱质心是衡量声音“亮度”的核心物理量,它指示了频谱能量质量中心的位置。在正常工况下,SC 特征表现为无规律的宽频分布;而在异常工况下,由于存在机械摩擦或转子不平衡,SC 曲线会呈现出极具规律性的高频震荡周期。
- 梅尔频谱图 (Mel Spectrogram): 相比于传统的对数功率谱,梅尔刻度更加贴合人类听觉系统对低频敏感、高频迟钝的非线性感知特性。通过将频率域映射到梅尔尺度,系统能够极其敏锐地捕获隐藏在低频带中的微弱机械异常撞击与磨损声。
2. LSTM-自编码器 (LSTM-AE) 的深度混合架构
将提取到的多维特征序列直接送入传统的全连接网络会导致维度灾难。为此,研究团队设计了 LSTM-Autoencoder 混合架构。
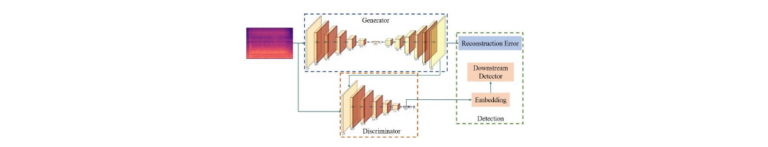
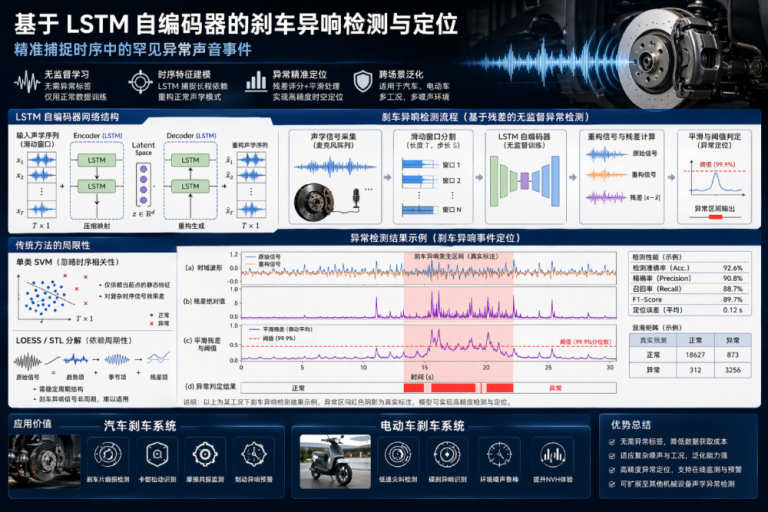
- 自编码器 (Autoencoder, AE) 机制: 自编码器由编码器(Encoder)和解码器(Decoder)组成。编码器负责将高维的声学输入序列“压缩”至一个低维的潜在特征空间中,强迫网络学习音频数据中最核心、最本质的底层变化规律;随后解码器试图将这些低维特征还原重构。这种机制能够极其有效地过滤掉随机的工厂背景噪声。
- 长短期记忆网络 (LSTM) 细胞: 为了让自编码器具备“记忆”能力,网络中的所有层均由 LSTM 单元构成。LSTM 通过其内部精密的门控机制——输入门 (Input gate, it ) 决定写入多少新信息、遗忘门 (Forget gate, ft) 决定丢弃多少历史包袱、以及输出门 (Output gate, ot) 决定向下一层传递多少状态——完美解决了传统 RNN 极易发生的梯度消失问题,使其能够处理音频中跨越数千个时间步的长程依赖关系。
3. 对比基线模型的设计 (Baseline Architectures)
为了严谨地证明 LSTM-AE 架构的优越性,研究团队不仅训练了这一种模型,还基于 RNN 家族设计了另外四种强大的基线模型进行全面陪跑与对比:单层 GRU、多层堆叠 GRU (Stacked GRU)、单层 LSTM 以及多层堆叠 LSTM (Stacked LSTM)。其中,GRU(门控循环单元)作为 LSTM 的轻量化变体,拥有更少的门控结构和更快的计算速度。
四、 实验设计与性能验证
为了验证该算法在极具挑战性的工业现场的表现,研究团队使用了由 Well Checked Systems International 提供的真实压缩机涡轮(Turbo)组件数据集。
1. 极度不平衡的大规模数据集
该数据集包含了总计 12,190 个真实采样的音频信号(格式为 OGG,每段时长 3 秒)。其中,代表正常运行声音的样本有 8,559 个,而包含噪音或故障的异常样本仅有 3,631 个。这种“正常多、异常少”的高度不平衡性(Imbalanced data)真实反映了工业现场的统计规律,但也对分类器的召回能力提出了极其严苛的考验。
实验采用了 80% 作为训练集,剩余的 20% 平分为独立的验证集(10%)和测试集(10%),以严格防止数据泄露(Data leakage)。
2. 超参数调优与网络配置
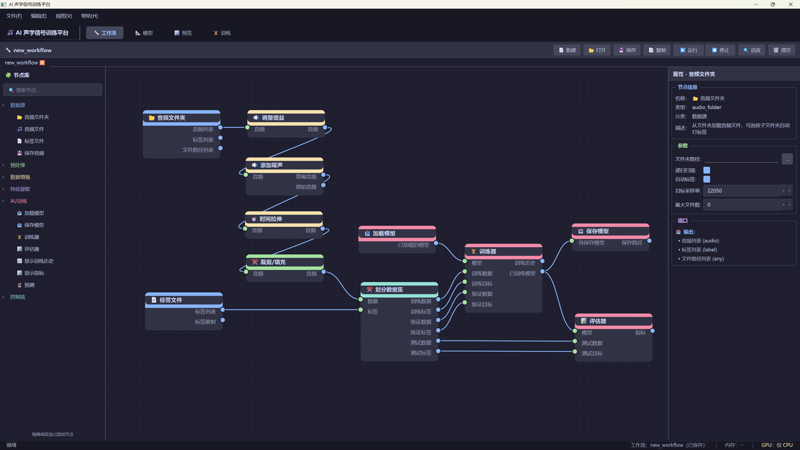
网络配置是一项极其耗时的经验性工程。经过大量的调优,LSTM-AE 最终确立了包含 8 个隐藏层、每层 **50 个神经元单元(units)**的深度架构。为了防止过拟合,模型引入了 0.1 的 Dropout 丢弃率。在分类决策层,对比测试了 Sigmoid 和 SoftMax 激活函数,并在损失函数上对比了均方误差(MSE)与稀疏分类交叉熵(Sparse categorical cross entropy),最终采用 Adam 优化器以 128 的批次大小(Batch size)迭代训练了 50 个 Epochs。
五、 核心研究结论与亮点剖析
通过极其严密的代码实现与硬件演算,本研究得出了几项极具学术与工业应用价值的结论。
1. LSTM-AE 实现 100% 的完美“大满贯”拦截
在四项极其严苛的核心评估指标——准确率 (Accuracy)、精确率 (Precision)、召回率 (Recall) 和 F1分数 (F1-score)——的考核下,LSTM-AE 模型展现出了令人惊叹的统治力。
实验结果表(Table 13, Table 14)清晰地显示:在测试集上,当采用 Sparse categorical cross entropy 和 SoftMax 函数时,LSTM-AE 模型在上述四项指标中全部达到了 100% 的完美得分。这意味着在长达数千条的未见测试数据中,模型没有发生任何一次误报(假阳性 FP)或漏报(假阴性 FN)。F1分数达到 100%,不仅彻底征服了数据不平衡带来的偏倚,更确立了该架构在当前数据集上的检测“天花板”。
2. 架构设计优于单纯的“参数堆砌”
本研究揭示了一个极其重要的深度学习工程定律:单纯增加模型参数量并不等同于性能的提升,恰当的特征重构架构更为关键。
通过深度剖析模型参数量直方图(Figure 11),我们可以发现:多层堆叠的 Stacked LSTM 模型拥有高达 102,502 个可训练参数,是所有模型中最庞大的;而夺冠的 LSTM-AE 模型的参数量仅为 93,004 个。然而,Stacked LSTM 在测试集上的 F1 分数为 99%,未能像 LSTM-AE 那样达到完美的 100%。这强有力地证明了,自编码器(AE)通过“压缩再解压”强制剥离环境噪声的架构机制,在提升工业异音表征能力上,远胜于简单粗暴的参数网络堆叠。
3. 计算时间与精度的合理权衡 (Trade-off)
作者秉持严谨的学术态度,客观呈现了模型的计算开销(Table 15)。单层 GRU 和单层 LSTM 训练 50 个 Epochs 仅需约 52 秒(平均每 Epoch 1.04 秒),而引入自编码机制的 LSTM-AE 总训练时间长达 801 秒(平均每 Epoch 16.02 秒)。尽管 LSTM-AE 的训练时间大幅增加,但考虑到工业预测性维护系统的核心诉求是“绝对可靠的故障侦测”而非“毫秒级的模型再训练”,这种为了实现零误报/零漏报而牺牲非实时训练时间的权衡,在工程落地中是完全可以接受且极其值得的。
4. 泛化与抗过拟合能力的可视化验证
通过绘制模型在 50 个 Epoch 迭代周期内的 Accuracy 曲线(Figure 9)和 Loss 曲线(Figure 10),可以清晰地观察到,LSTM-AE 的训练集曲线与验证集曲线高度吻合且收敛极快,最终差距趋近于零。这从数学理论上彻底排除了过拟合(Overfitting)与欠拟合(Underfitting)的嫌疑,证实了模型真正学到了压缩机正常与异常声学序列的通用本质规律,具备向现实工厂泛化部署的巨大潜力。
六、 局限性与未来研究展望
该文献不仅为压缩机声学监控确立了全新的算法标杆,也为未来的学术探索指明了方向:
- 数据分布的挑战: 尽管系统取得了完美的指标,但作者指出,未来仍需收集涵盖更广泛工况、更具平衡性以及包含更多故障子类别(如轴承裂纹、阀门泄漏细分)的大规模音频数据集,以挑战该算法的泛化极限。
- 变分自编码器(VAE)的引入: 作为下一步的研究蓝图,团队建议将传统的确定性 AE 升级为变分自编码器 (Variational Autoencoder, VAE)。VAE 能够通过学习输入数据的潜在概率分布规律(而非仅仅重构输入),从而在概率层面上计算重构误差。这对于捕捉那些低概率、极度罕见且从未见过的边缘异常(Unseen anomalies),将提供更为强悍的统计学保障。
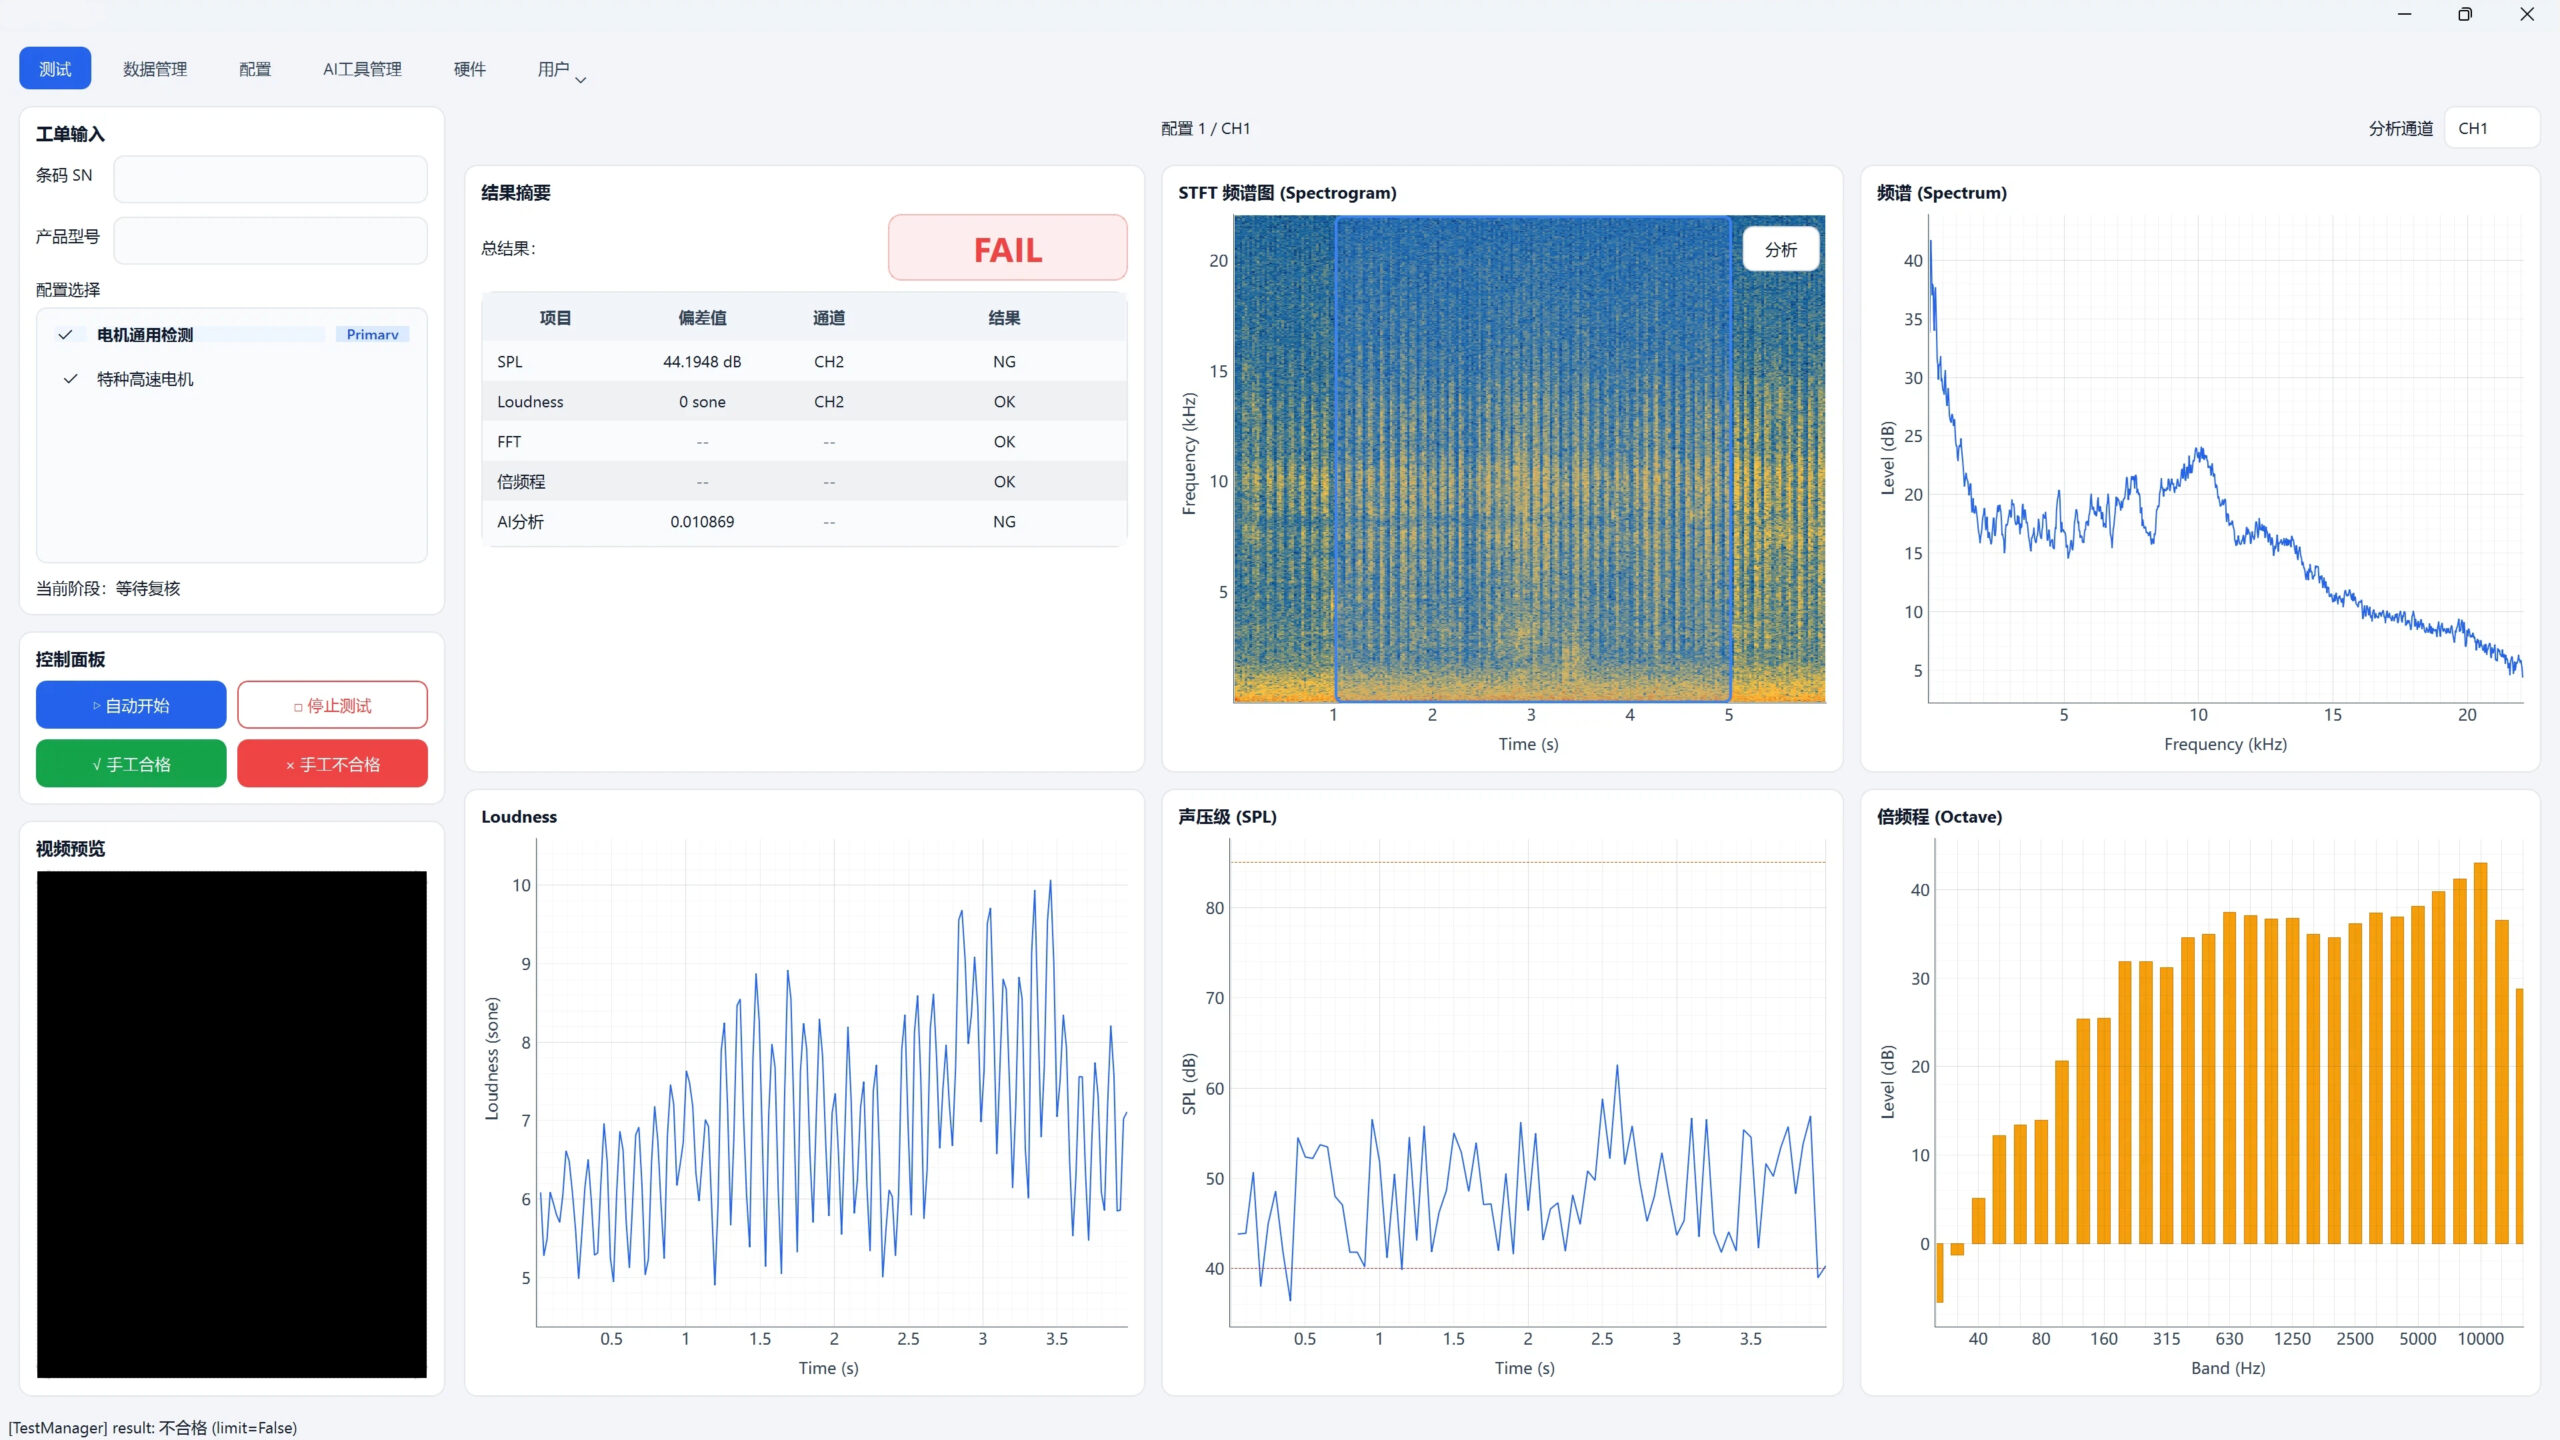
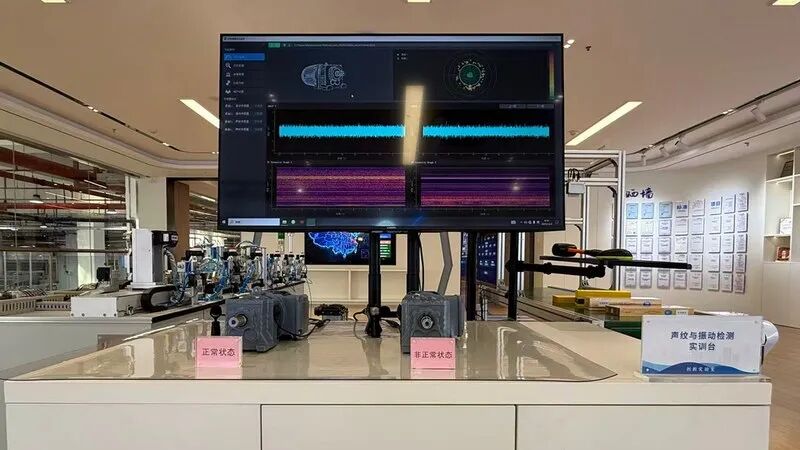
总结而言,本文通过创造性地将谱质心与梅尔频谱等一维深度时序特征注入 LSTM-Autoencoder 框架,成功打破了传统工业音频分类的精度瓶颈。该研究为实现完全自动化、免人工干预的“工业 4.0”预测性维护体系贡献了极具商业化价值的算法基石。苏州东原电子长期专注于声学测量、工业异音异响检测及声学测试设备研发,可根据不同设备的结构特点、运行工况和噪声环境,构建从声音采集、信号处理、特征分析、AI算法识别到检测结果输出的一体化异音检测方案。针对电机异音、减速机异响、风机异音、泵类异常声音以及汽车零部件NVH异音等应用场景,可结合实际生产需求开发自动化检测系统,帮助企业减少人工听音依赖,提高产品质量检测的一致性和检测效率。
未来,随着AI声学算法、边缘计算和智能传感技术的发展,AI异音异响检测系统将进一步从“发现异常”向“识别故障类型、判断异常程度和预测设备状态”发展,为工业设备质量控制和预测性维护提供更加可靠的技术支撑。
P. Mobtahej, X. Zhang, M. Hamidi, and J. Zhang, “An LSTM-Autoencoder Architecture for Anomaly Detection Applied on Compressors Audio Data,” Computational and Mathematical Methods, vol. 2022, Article ID 3622426, pp. 1-22, 2022.
🤝我们能为您提供的支持🤝